Modelos
Modelos de IA disponíveis no Foxl
O Foxl Agent oferece suporte às suas próprias chaves de API e contas em nuvem (BYOK, incluindo o Amazon Bedrock), modelos locais e os logins compatíveis com o ChatGPT e o Gemini CLI (BYOA). Configure-os em Configurações > Modelo e provedor. O uso de modelos por este caminho local continua sendo cobrado pelo seu provedor.
O code.foxl.ai é um SaaS gerenciado e separado. O seu orquestrador e os agentes de código gerenciados usam créditos do Foxl Relay. O Kiro e o Cursor remotos usam uma chave de API do fornecedor salva nas configurações do Code e cobram créditos do Foxl apenas pela computação. As tarefas remotas do Code abertas a partir do aplicativo de desktop usam esses mesmos caminhos de acesso. Veja Acesso aos modelos do Code.
Modelos BYOK
Traga a sua própria chave: todos os modelos desta seção funcionam com as credenciais que você fornece, e o uso é cobrado pelo provedor na sua conta (ou não custa nada, no caso de um modelo local), e não pelo Foxl. O Amazon Bedrock também é BYOK - o Foxl o chama com a sua própria conta AWS. Veja Provedores de IA para a configuração.
Amazon Bedrock (sua própria conta AWS)
Estes modelos funcionam na sua própria conta AWS: conecte-a em Configurações > Modelo e provedor > Amazon Bedrock, e a AWS cobra o uso dessa conta. Quais modelos você pode chamar, e os respectivos limites de contexto, dependem do que a sua conta tem habilitado na sua Região. O catálogo gerenciado do Code é listado separadamente na página vinculada acima.
| Modelo | Criado por | Contexto | Melhor para |
|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 1M tokens | Padrão do Foxl Agent e do Foxl Code; feito para programação agêntica de longa duração e trabalho com conhecimento, e mais barato que o Opus 5 ($4 / $20 por MTok) |
| Claude Opus 5 | Anthropic | 1M tokens | Padrão anterior; iguala ou supera o Fable 5 em programação agêntica e trabalho profissional com conhecimento, por metade do preço |
| Claude Fable 5.1 | Anthropic | 1M tokens | Modelo Claude para programação complexa e raciocínio |
| Kimi K3 | Moonshot | 1M tokens | Modelo de pesos abertos com visão nativa; programação longa e trabalho com conhecimento em grandes repositórios, documentos e imagens |
| GLM 5.3 | Z.AI | 1M tokens | Modelo de pesos abertos para programação agêntica e trabalho de engenharia longo e em várias etapas; somente texto, esforço de raciocínio de none a max |
| GLM 5 | Z.AI | 200K tokens | Legado: substituído pelo GLM 5.3; listado apenas com Mostrar versões de modelos antigas ativado |
| Kimi K2.5 | Moonshot | 256K tokens | Raciocínio e uso de ferramentas |
| Claude Fable 5 | Anthropic | 1M tokens | Estado da arte na maioria dos benchmarks; trabalho ambicioso de longa duração, visão avançada |
| Claude Opus 4.8 | Anthropic | 1M tokens | Padrão anterior de programação/desktop; execuções autônomas mais longas, menor variância de saída para fluxos corporativos |
| Claude Opus 4.7 | Anthropic | 1M tokens | Legado: mesma superfície de API do 4.8; listado apenas com Mostrar versões de modelos antigas ativado |
| Claude Opus 4.6 | Anthropic | 1M tokens | Legado: Opus mais antigo, ainda com contexto de 1M; listado apenas com Mostrar versões de modelos antigas ativado |
| Claude Sonnet 5.5 | Anthropic | 1M tokens | Sonnet mais recente: mais rápido que o Sonnet 5 a $2 / $10 por MTok; programação do dia a dia, correção de bugs e documentos |
| Claude Sonnet 5 | Anthropic | 1M tokens | Padrão das Notas; velocidade e qualidade equilibradas |
| Claude Sonnet 4.6 | Anthropic | 1M tokens | Legado: substituído pelo Sonnet 5 e 5.5; listado apenas com Mostrar versões de modelos antigas ativado |
| Claude Haiku 5.5 | Anthropic | 1M tokens | Modelo mais rápido, para trabalho de alto volume (títulos, sugestões, tradução, classificação) a $0,10 / $0,50 por MTok até 100K tokens de prompt |
| Claude Haiku 4.5 | Anthropic | 200K tokens | Legado: substituído pelo Haiku 5.5; listado apenas com Mostrar versões de modelos antigas ativado |
| GPT-6 Astra | OpenAI | 1,05M tokens | O modelo mais capaz da OpenAI, feito para o trabalho ponta a ponta mais difícil - raciocínio complexo, programação, uso do computador, pesquisa e criação de documentos |
| GPT-6.1 Sol | OpenAI | 1,05M tokens | Programação agêntica, uso do computador e trabalho profissional próximos do Astra, a $2 / $10 por MTok (entrada em cache $0,10). O raciocínio fica sempre ativado |
| GPT-6.1 Terra | OpenAI | 1,05M tokens | Nível intermediário rápido e eficiente para raciocínio visual, uso do computador e escrita, a $1 / $5 por MTok (entrada em cache $0,05). O raciocínio pode ser desligado |
| GPT-6 Sol | OpenAI | 1,05M tokens | Legado: substituído pelo GPT-6.1 Sol; listado apenas com Mostrar versões de modelos antigas ativado. Mesmo preço; ao contrário do 6.1, o raciocínio pode ser desligado |
| GPT-6 Luna | OpenAI | 1,05M tokens | O nível mais barato do GPT-6 ($0,10 / $0,50 por MTok); trabalho rápido e de alto volume |
| GPT-5.6 Sol | OpenAI | 1M tokens | Legado: substituído pela geração GPT-6; listado apenas com Mostrar versões de modelos antigas ativado |
| GPT-5.6 Terra | OpenAI | 1M tokens | Legado: substituído pelo GPT-6.1 Terra; listado apenas com Mostrar versões de modelos antigas ativado |
| GPT-5.6 Luna | OpenAI | 1M tokens | Legado: substituído pela geração GPT-6; listado apenas com Mostrar versões de modelos antigas ativado |
| GPT-5.5 | OpenAI | 272K tokens | Raciocínio de fronteira anterior da OpenAI; pode pesquisar na web com a Pesquisa na Web do Amazon Bedrock |
| GPT-5.4 | OpenAI | 272K tokens | Legado: raciocínio de uso geral da OpenAI; listado apenas com Mostrar versões de modelos antigas ativado |
| Grok 4.7 | xAI | 500K tokens | Modelo de fronteira da xAI para programação, tarefas agênticas e trabalho com conhecimento; feito para agentes de longa duração |
| Grok 4.6 | xAI | 500K tokens | Legado: substituído pelo Grok 4.7; listado apenas com Mostrar versões de modelos antigas ativado |
| Gemma 4 31B | 256K tokens | Barato e rápido para transformações mecânicas curtas (limpeza de ditado, resumos). Sem uso de ferramentas, sem visão |
Modelos substituídos ficam ocultos até você pedi-los. Opus 4.7, Opus 4.6, Sonnet 4.6, Haiku 4.5, GLM 5, GPT-6 Sol, GPT-5.6 Sol / Terra / Luna, GPT-5.4 e Grok 4.6 continuam totalmente executáveis - mesmo preço, mesma elegibilidade de nível, e uma seleção salva continua funcionando - mas saem de todos os seletores, a menos que Mostrar versões de modelos antigas esteja ativado em Configurações > Modelo e provedor. Também nos créditos do Foxl: desde 31 de outubro de 2026, GPT-6.1 Sol, GPT-6.1 Terra e GPT-6 Luna estão nos créditos, então GPT-5.6 Sol / Terra / Luna também são modelos antigos ali.
GPT-6.1 Sol (gpt-6.1-sol, lançado em 29 de setembro de 2026) é a atualização do GPT-6 Sol e substitui o modelo no seletor. Chega perto do GPT-6 Astra em programação agêntica, uso de computador e trabalho profissional, pelo preço do GPT-6 Sol: US$ 2 / US$ 10 por MTok, com entrada em cache a US$ 0,10 (antes US$ 0,20). Contexto de 1,05M, saída de 128K.
- O raciocínio fica sempre ativado. Como o GPT-6 Astra, aceita
lowatémax(padrãomedium) e recusanone, então o Foxl não oferece uma chave para desligá-lo. O GPT-6 Sol, que pode desligar o raciocínio, continua disponível com Mostrar versões de modelos antigas ativado. - Acesse nos créditos do Foxl (chat do Foxl Code, app.foxl.ai e os apps de celular), com a sua própria conta AWS (Configurações > Modelo e provedor > Amazon Bedrock) ou uma chave de API da OpenAI. Nos créditos do Foxl custa $2,20 / $11 por MTok ($0,11 em cache), o que o Amazon Bedrock cobra pela rota dentro da região que o Foxl usa.
- Também funciona com um login de assinatura ChatGPT Plus/Pro, confirmado funcionando nessa conexão - veja Modelos por assinatura (OAuth) abaixo. Ali a janela é de 500K em vez de 1,05M, e o GPT-6 Sol fica atrás de Mostrar versões de modelos antigas, como no Amazon Bedrock.
GPT-6.1 Terra (gpt-6.1-terra, lançado em 26 de outubro de 2026) é a faixa intermediária, rápida e eficiente da geração GPT-6 e a sucessora do GPT-5.6 Terra: raciocínio visual, uso preciso de computador e escrita clara por US$ 1 / US$ 5 por MTok, com entrada em cache a US$ 0,05. Contexto de 1,05M, saída de 128K.
- O raciocínio pode ser desligado. Aceita de
noneatémax(padrãomedium), como o GPT-6 Sol e o Luna, e diferente do GPT-6.1 Sol. - Acesse nos créditos do Foxl ($1,10 / $5,50 por MTok, $0,055 em cache) ou com a sua própria conta AWS (Configurações > Modelo e provedor > Amazon Bedrock).
- Também funciona com um login de assinatura ChatGPT Plus/Pro, confirmado funcionando nessa conexão - veja Modelos por assinatura (OAuth) abaixo. Ali a janela é de 500K em vez de 1,05M, e o raciocínio também pode ser desligado.
GPT-6 Sol e GPT-6 Luna (gpt-6-sol, gpt-6-luna, GA em 22 de setembro de 2026) são as faixas mais baratas da geração Astra, a metade do preço das contrapartes GPT-5.6: Sol $2 / $10 por MTok e Luna $0,10 / $0,50, com entrada em cache a um décimo do preço de entrada. Contexto de 1,05M, saída de 128K. O raciocínio é ajustável e PODE ser desligado - ao contrário do Astra, ambos aceitam o nível de esforço none - e o padrão é medium.
Acesse-os com a sua própria conta da AWS (Configurações > Modelo e provedor > Amazon Bedrock) ou com uma chave de API da OpenAI. Duas coisas que vale saber, ambas medidas e não presumidas:
- GPT-6 Luna está nos créditos do Foxl desde 31 de outubro de 2026, a $0,11 / $0,55 por MTok ($0,011 em cache). GPT-6 Sol não está: GPT-6.1 Sol o substitui ali.
- Eles também funcionam com um login de assinatura ChatGPT Plus/Pro, confirmado funcionando nessa conexão - veja Modelos por assinatura (OAuth) abaixo. Ali a janela é de 272K em vez de 1,05M, que é o limite do transporte para todo slug GPT e não algo específico desses dois.
O GPT-6 Astra pode ser usado no Foxl Agent com a sua própria conta da AWS, uma assinatura do ChatGPT ou uma chave de API da OpenAI. O acesso gerenciado no Code usa seu próprio catálogo e saldo de créditos. Veja Outras chaves de API e modelos locais e Modelos por assinatura (OAuth) abaixo.
Claude Opus 5.5 (claude-opus-5-5, GA 2026-09-22) é o novo padrão no Foxl Agent e no agente de código do Foxl Code, e sustenta o nível de complexidade expert no roteamento do aplicativo de desktop. Contexto de 1M, saída máxima de 128K, visão, corte de conhecimento em junho de 2026. Custa $4 / MTok de entrada e $20 / MTok de saída - MENOS que o Opus 5 que ele substitui ($5 / $25). Leituras de cache custam $0,20 / MTok (5% da entrada, como o Sonnet 5.5 desde 7 de outubro de 2026; a maioria dos outros modelos Claude cobra 10%) e gravações de cache de 5 minutos custam $5 / MTok.
O raciocínio não pode ser desligado neste modelo. O pensamento adaptativo fica sempre ativo, então o seletor de modelo mostra os níveis de esforço sem chave liga/desliga, e effort é o único controle de profundidade. O esforço padrão é medium, não o high que todas as outras faixas Opus usam - e no mesmo nível ele pensa mais por turno do que o Opus 5, então confira de novo uma configuração que você transporte em vez de presumir que o custo não mudou.
O uso forçado de ferramentas também foi removido: uma requisição que fixa tool_choice em uma ferramenta específica, ou em "qualquer ferramenta", é recusada. Nada no Foxl envia isso.
O Foxl Notes mantém o Sonnet 5 como padrão. O Opus 5 continua selecionável. No Foxl Agent, use o Opus 5.5 com suas próprias credenciais da Anthropic ou do Bedrock, ou com um login Claude Pro/Max pelo Claude Code. O Code gerenciado usa créditos do Foxl, cobrados pelo que o Amazon Bedrock cobra pelo perfil cross-Region dos EUA em que ele roda: $4,40 / $22 por MTok, 10% acima da tabela, como todo modelo Claude nos créditos do Foxl, exceto Sonnet 5.5 e Sonnet 5 (Tarifas de modelo usadas pelo Relay).
No Bedrock, o Opus 5.5 é us.anthropic.claude-opus-5-5. Os perfis de inferência cross-region us. e global. foram verificados ao vivo a partir de us-west-2 e us-east-1, então não há fixação de região e não é exigida adesão à retenção de dados. O uso do computador não é afetado aqui: o Bedrock ainda aceita a ferramenta anterior computer_20251124 para este modelo, ao contrário da API Claude e do Google Cloud.
Claude Opus 5 (claude-opus-5, GA 2026-07-24) é o padrão anterior do Foxl Agent e do agente de código do Foxl Code. Continua selecionável junto com o Opus 5.5. Tem contexto de 1M, saída máxima de 128K, visão e corte de conhecimento em maio de 2026. Custa $5 / MTok de entrada e $25 / MTok de saída. Leituras de cache custam $0,50 / MTok e gravações de cache de 5 minutos custam $6,25 / MTok. Use-o com suas próprias credenciais da Anthropic ou do Bedrock, ou com uma assinatura Claude Pro/Max.
Claude Sonnet 5.5 (claude-sonnet-5-5, GA 2026-09-28) é o Sonnet mais recente. Ele pode ser selecionado com sua própria chave da Anthropic ou credenciais do Bedrock, com um login Claude Pro/Max, no Foxl Notes e no Foxl Code com créditos Foxl. O Sonnet 5 continua sendo o padrão do Foxl Notes. Contexto de 1M, saída máxima de 128K, visão e data de corte de conhecimento em junho de 2026. Custa $2 / MTok de entrada e $10 / MTok de saída, com gravações de cache de 5 minutos a $2,50 / MTok. As leituras de cache custam $0,10 / MTok desde 7 de outubro de 2026, metade dos $0,20 anteriores - na API da Claude, no Amazon Bedrock (a AWS reduziu o preço no mesmo dia) e, portanto, nos créditos Foxl, que cobram o que o Bedrock cobra.
O raciocínio não pode ser desligado neste modelo, assim como no Opus 5.5: o seletor de modelo mostra seus cinco níveis de esforço sem chave liga/desliga. O Foxl define o esforço padrão como medium. Os níveis de esforço foram recalibrados neste modelo, então um nível não produz a mesma quantidade de raciocínio que no Sonnet 5. O uso forçado de ferramentas é recusado, como no Opus 5.5; nada no Foxl o envia.
No Bedrock, o Sonnet 5.5 é global.anthropic.claude-sonnet-5-5. Esse perfil cross-region global é o único: um perfil us. não existe para este modelo. Foi verificado ao vivo a partir de us-west-2 e us-east-1. Um perfil global pode direcionar uma requisição para qualquer Região comercial da AWS (AWS: inferência cross-Region), então, ao contrário dos outros modelos Claude nos créditos do Foxl, uma requisição ao Sonnet 5.5 não fica restrita aos EUA. O modo Claude Code (login Pro/Max) também o lista, limitado a 200K tokens ali, como o Sonnet 5.
Claude Haiku 5.5 (claude-haiku-5-5, GA 2026-10-07) é o Haiku mais recente e substitui o Haiku 4.5, que passa para os modelos anteriores. É o pequeno modelo rápido do Foxl: as sugestões de saudação, os resumos de sessão no Amazon Bedrock e o orquestrador de chat do Foxl Code rodam nele; ele nomeia conversas no Amazon Bedrock com sua própria conta da AWS e com um login Claude Pro/Max (e no OpenRouter quando o modelo gratuito de nomeação não consegue; veja Como as conversas são nomeadas); e os modelos de título e de tradução ao vivo do Foxl Notes também, quando definidos como Automático com uma chave da Anthropic (no Amazon Bedrock, o Automático executa primeiro o Gemma 4 31B e só usa o Haiku 5.5 se a conta recusar o Gemma 4 e o GPT-6 Luna; um login Claude Pro/Max não lista nenhum Haiku, então ali o Automático executa o próprio modelo do Foxl Agent). Contexto de 1M (o Haiku 4.5 tinha 200K), saída máxima de 128K, visão, corte de conhecimento em junho de 2026.
O preço depende do tamanho do prompt. Até 100.000 tokens de prompt, custa $0,10 / MTok de entrada e $0,50 / MTok de saída, com leituras de cache a $0,01 e gravações de cache de 5 minutos a $0,125, um décimo dos preços do Haiku 4.5. Acima de 100.000 tokens, a requisição inteira é cobrada a cinco vezes essas tarifas. Ele também usa o tokenizador mais novo, então o mesmo texto conta cerca de 30% mais tokens do que no Haiku 4.5.
O pensamento é adaptativo e pode ser desligado. Ao contrário do Haiku 4.5, ele pensa quando a requisição não menciona pensamento, então o Foxl envia o pensamento desligado explicitamente sempre que ele é desligado e em toda chamada auxiliar - um título ou um segmento de tradução roda sem raciocínio, como no Haiku 4.5. Com o pensamento ligado, aceita níveis de esforço de low a max; o padrão é medium. temperature, top_p e top_k são recusados, e também um preenchimento prévio do assistente; nada no Foxl envia qualquer um deles.
No Bedrock, é us.anthropic.claude-haiku-5-5 nos créditos do Foxl (o perfil cross-Region dos EUA, $0,11 / $0,55 por MTok, 10% acima da tabela, como os outros modelos Claude) e global.anthropic.claude-haiku-5-5 na sua própria conta da AWS. Ambos os perfis foram verificados ao vivo a partir de us-west-2.
O que mudou para ele. Um modelo auxiliar do Notes deixado no padrão passa para o Haiku 5.5 sozinho, e o mesmo acontece com um auxiliar do Notes definido como Haiku 4.5 - os dois não podem ser distinguidos, porque o Haiku 4.5 era o padrão armazenado. Qualquer outra seleção salva (um modelo de chat, uma agenda, uma definição de agente) continua executando o modelo que ela nomeia, inclusive o Haiku 4.5. A compactação de contexto não muda: ela resume com o modelo em que a conversa roda, que lê o cache de prompt desse modelo.
No Bedrock, o Opus 5 é us.anthropic.claude-opus-5 (ambos os perfis de inferência cross-region us. e global. funcionam, sem fixação de região) e roda com retenção zero de dados por padrão - nenhuma adesão à retenção de dados é exigida, ao contrário do Fable 5. Prompts de maior risco podem ser respondidos pelo Opus 4.8 e são cobrados às tarifas do Opus.
O Managed Code oferece GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra, GPT-6 Luna, a família GPT-5.6 (Sol, Terra, Luna) e GPT-5.5 / GPT-5.4 pela API nativa OpenAI Responses do Amazon Bedrock. Uma tarefa do Codex roda GPT-6 Astra, GPT-5.6 e GPT-5.5 / GPT-5.4. No Foxl Agent, use sua própria conta AWS ou uma chave de API da OpenAI. Os modelos de assinatura do ChatGPT compatíveis estão listados abaixo; esse caminho exclui GPT-5.4 e GPT-5.4 Mini. Todos os três níveis do GPT-5.6 aceitam esforço de raciocínio até max.
A partir de 3 de agosto de 2026, GPT-5.6 Sol, Terra e Luna atendem a janela completa de 1M tokens no Amazon Bedrock, então um repositório inteiro, um contrato longo ou um histórico completo de agente com várias etapas cabe em uma única requisição. O cache de prompts com pontos de quebra explícitos se aplica a essas requisições de contexto longo, e o contexto repetido é cobrado com 90% de desconto.
GPT-5.5 e GPT-5.4 continuam limitados a 272K tokens (278.528) no Bedrock: o anúncio da AWS cobre apenas a geração 5.6.
O transporte OAuth do ChatGPT (Codex) usa 272K para a família GPT, incluindo a trinca 5.6 e o GPT-6 Astra. Esse 1M é do Bedrock e não se aplica a uma assinatura. As exceções são GPT-6.1 Sol e GPT-6.1 Terra, com 500K. Os números são do próprio endpoint do Codex: todos os outros modelos que ele serve informam context_window: 272000, e os dois modelos GPT-6.1 informam 500000. O Foxl usa o limite do provedor ativo para o medidor de contexto e a configuração do modelo, então o mesmo modelo mostra uma janela diferente conforme a forma de conexão.
O GPT-5.6 introduz escritas de cache de prompt cobradas (1,25x a taxa de entrada) junto com leituras de cache com desconto (90% de desconto). O Foxl mede ambas com precisão: o tráfego GPT em cache é cobrado à taxa de leitura com desconto, não ao preço cheio de entrada.
Grok 4.7 (grok-4.7, GA no Amazon Bedrock em 2026-09-28) é o modelo de fronteira da xAI para programação, tarefas agentic e trabalho com conhecimento, com janela de contexto de 500K tokens, entrada de imagem e documento, e esforço de raciocínio low, medium, high ou xhigh. Seu raciocínio não pode ser desligado, então o seletor de modelo mostra os níveis de esforço sem chave de ligar/desligar; o Foxl o inicia em high, o padrão da plataforma. Custa $2,20 / MTok de entrada e $6,60 / MTok de saída, com leituras de cache a $0,55 / MTok, tanto nos créditos Foxl quanto na sua própria conta AWS.
Grok 4.6 (grok-4.6) é o Grok anterior e agora é uma versão de modelo antiga: oculto por padrão, mas ainda selecionável com Mostrar versões antigas de modelos ativado. Seu raciocínio também não pode mais ser desligado (o Bedrock agora recusa o esforço none para ele), então uma requisição com raciocínio desligado roda em low. Mesmo preço do Grok 4.7.
Ultrafast nos créditos Foxl. Com Grok 4.7, Grok 4.6 ou Gemma 4 31B nos créditos Foxl, a chave Ultrafast do seletor de modelo executa suas mensagens no Priority tier do Amazon Bedrock, cobrado a 1,75 vez o preço Standard: $3,85 / MTok de entrada, $11,55 / MTok de saída e $0,9625 / MTok de leitura de cache para o Grok; $0,245 / MTok de entrada e $0,70 / MTok de saída para o Gemma 4 31B. Desligado é Standard. No celular ou em app.foxl.ai, a chave aparece enquanto você conversa por um computador com o Foxl 0.9.9 ou posterior.
Ele é servido a partir de us-west-2, a única região que o Bedrock oferece nesse endpoint, independentemente de onde os modelos GPT são servidos.
GLM 5.3 (Z.AI) e Kimi K2.5 (Moonshot) estão disponíveis no Foxl Agent com sua própria conta AWS (Amazon Bedrock em Configurações > Modelo e provedor). Eles não estão nos créditos do Foxl Relay: uma seleção de qualquer um deles com créditos Foxl muda para o Claude Haiku 5.5, e o Foxl informa isso. Os dois fornecedores também oferecem seus modelos mais novos diretamente - adicione uma chave da Z.ai ou da Kimi no mesmo painel.
O Kimi K3 é apenas com sua própria conta AWS: não está nos créditos Foxl Relay, então aparece somente no Amazon Bedrock. O Foxl o chama pela API Responses compatível com OpenAI do Bedrock em vez do Converse, que é o que a AWS recomenda para este modelo e o que permite ler um PDF anexado e reutilizar um prompt em cache; no Converse, o mesmo modelo recusa ambos. O GLM 5 foi substituído pelo GLM 5.3 e fica no grupo de modelos antigos, oculto até você ativar a chave de mostrar modelos legados nas Configurações; ele continua funcionando exatamente como antes, incluindo seleções salvas e tarefas agendadas. O GLM 5.3 roda apenas pelo perfil de inferência cross-Region dos EUA do Bedrock, que o Foxl usa automaticamente. Hoje a AWS serve esse perfil a partir de us-east-1 e us-west-2 (padrão do Foxl), então, se sua conta estiver em outra região, este modelo responde com erro. A Amazon também oferece o GLM 5.3 apenas a contas AWS aprovadas por ela.
O Claude Fable 5 vem com salvaguardas integradas. Prompts em domínios sensíveis (cibersegurança, biologia, química, saúde) são respondidos automaticamente pelo Opus 4.8 e cobrados à taxa do Opus.
Outras chaves de API e modelos locais
| Modelo | Provedor | Contexto | Chave de API em |
|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 1M tokens | console.anthropic.com |
| Claude Opus 5 | Anthropic | 1M tokens | console.anthropic.com |
| Claude Fable 5 | Anthropic | 1M tokens | console.anthropic.com |
| Claude Fable 5.1 | Somente Amazon Bedrock | 1M tokens | sua própria conta AWS: o Foxl o lista somente em Amazon Bedrock |
| Claude Opus 4.8 | Anthropic | 1M tokens | console.anthropic.com |
| Claude Sonnet 5.5 | Anthropic | 1M tokens | console.anthropic.com |
| Claude Sonnet 5 | Anthropic | 1M tokens | console.anthropic.com |
| Claude Haiku 5.5 | Anthropic | 1M tokens | console.anthropic.com |
| Claude Opus 4.7, Opus 4.6, Sonnet 4.6 | Anthropic | 1M tokens | geração antiga: aparece quando Mostrar versões antigas de modelos está ativado |
| Claude Haiku 4.5 | Anthropic | 200K tokens | geração antiga: aparece quando Mostrar versões antigas de modelos está ativado |
| GPT-6 Astra | OpenAI ou Amazon Bedrock | 1,05M tokens | platform.openai.com, ou sua própria conta AWS como us.openai.gpt-6-astra |
| GPT-6.1 Sol | OpenAI ou Amazon Bedrock | 1,05M tokens | platform.openai.com, ou sua própria conta AWS como us.openai.gpt-6.1-sol |
| GPT-6.1 Terra | Amazon Bedrock | 1,05M tokens | sua própria conta AWS como us.openai.gpt-6.1-terra |
| GPT-6 Sol | OpenAI ou Amazon Bedrock | 1,05M tokens | geração antiga: aparece quando Mostrar versões antigas de modelos está ativado |
| GPT-6 Luna | OpenAI ou Amazon Bedrock | 1,05M tokens | platform.openai.com, ou sua própria conta AWS como us.openai.gpt-6-luna |
| GPT-5.6 Sol / Terra / Luna | OpenAI | 1M tokens | geração antiga: aparece quando Mostrar versões antigas de modelos está ativado |
| GPT-5.5 | OpenAI | 1M tokens | platform.openai.com |
| GPT-5.4, GPT-4.1, GPT-4.1 Mini, o3, o4-mini, GPT-4o | OpenAI | 1M / 200K / 128K | geração antiga: aparece quando Mostrar versões antigas de modelos está ativado em Configurações > Modelo e provedor |
| Gemini 3.8 Flash | 1M tokens | aistudio.google.com | |
| Gemini 3.5 Flash-Lite | 1M tokens | aistudio.google.com | |
| Gemini 4 Argon | 1M tokens | aistudio.google.com, somente com chave de API paga; uma chave do plano gratuito é recusada com erro de cota | |
| Gemini 2.5 Pro, Gemini 2.5 Flash | 1M tokens | geração antiga: aparece quando Mostrar versões antigas de modelos está ativado | |
| Todo o catálogo do Bedrock | Amazon Bedrock | Varia | sua própria conta AWS: todos os modelos em Amazon Bedrock acima |
| Gemma 4 E4B, E2B, 12B | Neste dispositivo (Mac com Apple Silicon, PC com Windows ou computador Linux x64) | 32K tokens (64K com 32 GB de memória) | Gratuito: um download em Configurações > Modelo e provedor > Neste dispositivo, veja Provedores de IA |
| Llama 3, Mistral etc. | Ollama | Varia | Gratuito: ollama.com |
| O que o catálogo do fornecedor informar | OpenRouter, DeepSeek, Groq, Together, Mistral, Fireworks, Z.ai, Kimi, Qwen, MiniMax, Perplexity, xAI, Cerebras, SambaNova, Cohere, AI21, Hugging Face | Varia | a chave do próprio fornecedor: o Foxl pede a cada fornecedor configurado a lista de modelos ao vivo |
| Qualquer modelo que seu servidor carregar | vLLM, LM Studio | Varia | Gratuito: um endpoint local compatível com OpenAI |
Modelos de assinatura (OAuth)
Modelos disponíveis por meio de login com assinatura. Somente no desktop - veja Provedores para a configuração. Para Claude Pro/Max e ChatGPT Plus/Pro, o Foxl chama a API do fornecedor diretamente com o seu token OAuth, e em Configurações > Modelo e provedor você vê quanto dos limites de 5 horas e semanais do plano já foi usado (Uso do plano). O Gemini CLI é diferente: o Foxl executa o próprio gemini CLI, então os modelos dele respondem sem as ferramentas do Foxl e não podem executar agendamentos nem outras tarefas em segundo plano.
Claude Code (Anthropic Pro/Max)
| Modelo | Contexto | Melhor para |
|---|---|---|
| Opus 5.5 (modo Claude Code) | 1M tokens | Modelo principal atual (claude-code/claude-opus-5-5); programação agêntica de longa duração. Verificado sendo atendido pelo pool de assinatura, com contexto de 1M nativo. O alias legado claude-code/opus agora aponta para cá |
| Opus 5 (modo Claude Code) | 1M tokens | Modelo principal anterior (claude-code/claude-opus-5); programação, fluxos agênticos, autonomia de longo prazo |
| Fable 5 (modo Claude Code) | 1M tokens | Estado da arte; o mais capaz para trabalhos ambiciosos e de longa duração |
| Opus 4.8 (modo Claude Code) | 1M tokens | Modelo principal anterior; programação, fluxos agênticos, autonomia de longo prazo |
| Opus 4.7 (modo Claude Code) | 1M tokens | Faixa Opus estável; mesma superfície de API do 4.8. Atrás de Mostrar versões mais antigas de modelos |
| Sonnet 5.5 (modo Claude Code) | 200K tokens | Sonnet mais recente (claude-code/claude-sonnet-5-5); raciocínio sempre ativo, apenas níveis de esforço (limite de 200K no pool de assinatura) |
| Sonnet 5 (modo Claude Code) | 200K tokens | Inteligência próxima à do Opus; velocidade e qualidade equilibradas (limite de 200K no pool de assinatura) |
| Fable 5.1 (modo Claude Code) | 1M tokens | Modelo da classe Mythos mais capaz. Exige créditos de Uso extra na sua conta Anthropic - veja abaixo |
| Sonnet 4.6 (modo Claude Code) | 200K tokens | Sonnet anterior (limite de 200K no pool de assinatura). Atrás de Mostrar versões mais antigas de modelos |
O Fable 5.1 é oferecido aqui, mas não faz parte do pool de assinatura Pro/Max. Medido
no transporte ativo: com a versão do CLI limpa, um token Pro responde
HTTP 429 "Usage credits are required for this model." em todas as requisições. A Anthropic
serve o Fable 5.1 a contas que têm créditos de Uso extra e cobra esse uso desses créditos,
por isso a linha aparece para quem os possui. Uma conta sem créditos recebe essa mensagem
imediatamente, e não depois de um intervalo de nova tentativa. O Fable 5.1 também está
disponível pelo Amazon Bedrock com a sua própria conta AWS, onde é cobrado pela taxa usual por
token.
O Claude Code (OAuth) roda em modo de compatibilidade, para que as requisições passem pela sua assinatura Claude Pro/Max em vez do "Uso extra" pago por uso. Nesse modo o agente recebe apenas Bash, Read, Grep e WebFetch; todas as outras ferramentas, incluindo gravação de arquivos, memória, subagentes, agendamentos, navegador e suas ferramentas MCP e personalizadas, ficam de fora, e Configurações > Modelo e provedor as lista pelo nome. Nem o Haiku 4.5 nem o Haiku 5.5 são expostos nesse modo. Para a superfície completa de ferramentas do Foxl, use uma chave de API da Anthropic (BYOK) ou o Claude no Amazon Bedrock pela sua própria conta AWS.
Os termos da Anthropic não permitem que aplicativos como o Foxl usem uma assinatura Claude dessa forma, e a Anthropic pode aplicar essas regras sem aviso prévio, o que pode afetar a sua conta Claude. O Foxl informa isso onde este login é configurado ou escolhido pela primeira vez; veja Provedores de IA.
OpenAI (ChatGPT Plus/Pro)
Todas as linhas abaixo têm 272.000 tokens neste transporte, exceto GPT-6.1 Sol e GPT-6.1 Terra, que têm 500.000 - os valores exatos do endpoint Codex, e não o 1M que o Bedrock oferece. Veja o aviso de janela de contexto acima.
| Modelo | Contexto | Melhor para |
|---|---|---|
| GPT-6 Astra | 272K tokens | O modelo mais capaz da OpenAI; trabalhos complexos e exigentes. O raciocínio está sempre ativo (low - max, padrão low) |
| GPT-6.1 Sol | 500K tokens | A evolução do GPT-6 Sol; próximo do Astra em programação agêntica e trabalho profissional. O raciocínio está sempre ativo (low - max, padrão medium) |
| GPT-6.1 Terra | 500K tokens | Nível intermediário rápido e eficiente para raciocínio visual, uso de computador e escrita. O raciocínio pode ser desligado |
| GPT-6 Luna | 272K tokens | Nível GPT-6 mais rápido; trabalho de alto volume. O raciocínio pode ser desligado |
| GPT-6 Sol | 272K tokens | Sol anterior; o raciocínio pode ser desligado. Atrás de Mostrar versões mais antigas de modelos |
| GPT-5.6 Sol | 272K tokens | Modelo de raciocínio principal anterior. Atrás de Mostrar versões mais antigas de modelos |
| GPT-5.6 Terra | 272K tokens | Nível equilibrado anterior. Atrás de Mostrar versões mais antigas de modelos |
| GPT-5.6 Luna | 272K tokens | Nível rápido anterior. Atrás de Mostrar versões mais antigas de modelos |
GPT-5.5, GPT-5.4 e GPT-5.4 Mini não estão neste transporte. A OpenAI não os serve a contas
do ChatGPT - medido no endpoint ativo, toda requisição responde
HTTP 400 "The 'gpt-5.4' model is not supported when using Codex with a ChatGPT account."
(e o mesmo para gpt-5.4-mini e, desde outubro de 2026, gpt-5.5) - por isso nenhum deles está
nesta lista. GPT-5.5 e GPT-5.4 ainda são acessíveis pelo Amazon Bedrock com a sua própria conta
AWS ou com uma chave de API da OpenAI (GPT-5.4 atrás de Mostrar versões mais antigas de
modelos). O Foxl não oferece o GPT-5.4 Mini em nenhum provedor.
GPT-6 Astra (gpt-6-astra, lançado em 4 de setembro de 2026; GA no Amazon Bedrock em
8 de setembro de 2026) é o modelo mais capaz da OpenAI.
Contexto de 1.050.000 tokens, máximo de 128.000 tokens de saída, entrada de texto e imagem, data de corte
de conhecimento em 30 de abril de 2026. Custa US$ 10 / MTok de entrada e US$ 50 / MTok de saída, com entrada em cache a
US$ 1 e escritas em cache a US$ 12,50 (1,25x a taxa de entrada sem cache). O transporte OAuth do ChatGPT
limita o contexto a 272K; todas as outras rotas oferecem a janela completa.
Prompts acima de 272K tokens de entrada custam mais. A OpenAI cobra esses a 2x das taxas de entrada e de cache e 1,5x na saída, para a requisição inteira. O medidor de uso do Foxl registra uma taxa por modelo, então uma requisição acima desse limite é subnotificada, e não cobrada incorretamente - e, na sua própria conta da AWS ou na sua própria chave de API, a conta é do fornecedor, não do Foxl.
Não há nível de raciocínio none: low, medium, high, xhigh e max são
aceitos, e none é recusado, então o Astra sempre raciocina. Com o raciocínio desligado, o Foxl
envia low em vez de um nível que faria a resposta falhar. Isso vale para as três rotas -
o Amazon Bedrock responde à mesma requisição com Unsupported value: 'none' is not supported.
No Amazon Bedrock, o Foxl o acessa de duas formas. Com a sua própria conta da AWS, ele chama o perfil de inferência entre regiões us.openai.gpt-6-astra, que funciona a partir de us-east-1, us-east-2 e us-west-2 sem fixar região. Nos créditos Foxl (Foxl Code), ele usa o endpoint OpenAI Responses do Bedrock como openai.gpt-6-astra, que serve este modelo somente em us-west-2 - o Foxl fixa essa região para você.
Ultrafast, com a sua própria conta AWS. O Amazon Bedrock também serve o GPT-6 Astra no seu nível Ultrafast (30 de setembro de 2026): o mesmo modelo, mais rápido, a seis vezes o preço Standard - US$ 66 / MTok de entrada, US$ 330 / MTok de saída e US$ 6,60 de entrada em cache no perfil dos EUA. Ative-o com a chave Ultrafast no seletor de modelo, que substitui o "Sempre ativo" fixo do Raciocínio; um ícone de raio no botão do modelo indica que está ativo. Vem desativado por padrão, aplica-se apenas às mensagens de chat que você envia (títulos e sugestões continuam no Standard, e uma execução agendada segue a própria chave do agendamento, abaixo), e os números de uso do Foxl contam essas mensagens a seis vezes a taxa Standard. A OpenAI informa velocidade de até seis vezes maior; na medição própria do Foxl, a maioria das respostas Ultrafast foi transmitida a 130-157 tokens por segundo contra 25-63 no Standard, embora uma não tenha sido mais rápida. Não está nos créditos Foxl: o endpoint Bedrock que os créditos Foxl usam para este modelo não oferece o nível. Os apps para celular e iPad e o app.foxl.ai mostram a mesma chave enquanto você conversa com o GPT-6 Astra pela conta AWS do seu desktop: ali ela se aplica às mensagens enviadas desse dispositivo, e até você alterá-la ali ela mostra e usa a configuração do próprio desktop. Com um desktop anterior ao Foxl 0.9.0, a chave ali fica desabilitada, no estado definido pelo desktop, com uma linha dizendo para atualizar o Foxl no computador para alterá-la a partir desse dispositivo, e as mensagens enviadas dele usam a configuração do desktop.
Um agendamento tem seu próprio botão Ultrafast, e o editor só o mostra depois que você escolhe um modelo para esse agendamento que o oferece (GPT-6 Astra na sua própria conexão com o Amazon Bedrock), e não enquanto o agendamento usa Igual ao Foxl Agent. Um agendamento já salvo dessa forma com o Ultrafast ligado o mantém, e o editor mostra o botão para que você possa desligá-lo ou escolher o modelo.
Também exposto como ferramenta integrada: gpt-image-2, pela ferramenta generate_image. Sem chave de API, sem cobrança por imagem - alimentado pela sua sessão OAuth do ChatGPT Plus/Pro. Aceita até 10 imagens de entrada para o modo de edição / composição.
Gemini CLI (Google)
| Modelo | Contexto | Melhor para |
|---|---|---|
| Gemini 3.1 Pro | 1M tokens | Documentos longos, análise aprofundada. Substitui o Gemini 3 Pro, que o Google desativou em 9 de março de 2026: um chat configurado com 3 Pro passa a usar o 3.1 Pro |
| Gemini 4 Argon | 1M tokens | Modelo de raciocínio principal do Google; apenas chaves de API pagas (veja abaixo) |
| Gemini 3.8 Flash | 1M tokens | Flash mais recente; rápido e econômico |
| Gemini 3.5 Flash | 1M tokens | Flash anterior |
| Gemini 3.5 Flash Lite | 1M tokens | Flash-Lite mais recente; o mais leve e o mais rápido |
| Gemini 3.1 Flash Lite | 1M tokens | Flash-Lite anterior |
| Gemini 2.5 Pro, Gemini 2.5 Flash | 1M tokens | Geração anterior, ainda servida pela CLI (e ainda o padrão dela). Ambos atrás de Mostrar versões de modelos antigas |
Com uma chave de API do Gemini, a própria CLI executa o Gemini 3.8 Flash quando você escolhe o 3.5 Flash, e o Gemini 3.5 Flash-Lite quando você escolhe o 3.1 Flash Lite; por isso, escolha a linha mais nova para que o Foxl registre o modelo que realmente foi executado. Uma CLI do Gemini mais antiga (anterior à 0.62) pode recusar o Gemini 3.8 Flash e o 3.5 Flash Lite; atualize-a se falharem.
Gemini 4 Argon (gemini-4-argon) é o modelo de raciocínio principal do Google, com contexto de 1.048.576 tokens. Ele está no seletor de modelos da Gemini CLI, do Google AI (sua própria chave de API) e do OpenRouter. O raciocínio dele não pode ser desligado, portanto não há opção de desligar; no OpenRouter você escolhe Baixo, Médio ou Alto. O Google o oferece apenas com chaves de API pagas, não no plano gratuito nem no Google AI Pro, de modo que uma chave gratuita do AI Studio é recusada com um erro de cota.
Raciocínio Adaptativo
Claude Opus 5.5, Opus 5, Fable 5.1, Fable 5, Opus 4.8, Opus 4.7, Opus 4.6, Sonnet 5.5, Sonnet 5, Sonnet 4.6 e Haiku 5.5 oferecem suporte a raciocínio adaptativo - o Claude decide dinamicamente quando e quanto raciocinar, com base na complexidade da sua solicitação. Não é necessário definir um orçamento manual.
- Perguntas simples: o Claude responde diretamente, sem o custo do raciocínio
- Problemas complexos: o Claude ativa automaticamente um raciocínio profundo
- Fluxos agênticos: o Claude pode raciocinar entre as chamadas de ferramentas (raciocínio intercalado)
O raciocínio adaptativo (type: "adaptive") é o modo recomendado para Opus 5.5, Opus 5, Fable 5.1, Fable 5, Opus 4.8 / 4.7 / 4.6, Sonnet 5.5, Sonnet 5, Sonnet 4.6 e Haiku 5.5 (Opus 5.5, Fable 5.1, Fable 5, Sonnet 5.5, Sonnet 5 e Haiku 5.5 aceitam apenas o adaptativo quando o raciocínio está ativado). O Haiku 4.5 usa type: "enabled" com o parâmetro budget_tokens.
Os níveis de esforço são por modelo, não uma lista única. Opus 5.5, Opus 5, Fable 5.1, Fable 5, Opus 4.8, Opus 4.7, Sonnet 5.5, Sonnet 5 e Haiku 5.5 expõem os cinco (baixo / médio / alto / xhigh / máximo); Opus 4.6 e Sonnet 4.6 expõem quatro - o xhigh surgiu depois deles. Opus 5, Fable 5.1, Fable 5, Opus 4.8, Opus 4.7 e Opus 4.6 usam high por padrão; Opus 5.5, Sonnet 5.5, Sonnet 5, Sonnet 4.6 e Haiku 5.5 usam medium por padrão.
No Opus 5.5 e no Sonnet 5.5 o raciocínio não pode ser desligado de forma alguma - type: "disabled" e o formato antigo budget_tokens são ambos recusados - por isso o seletor de modelos mostra os cinco níveis de esforço, sem botão de ligar/desligar.
No Opus 5, o raciocínio adaptativo fica ativado por padrão - essa é a mudança em relação ao Opus 4.8, em que era preciso ativá-lo manualmente. O Opus 5 expõe os cinco níveis de esforço (baixo / médio / alto / xhigh / máximo) e usa high por padrão. Ele também oferece suporte a resumos de raciocínio, e o max_tokens limita o raciocínio e o texto da resposta em conjunto.
O Opus 4.7 e o 4.8 também rejeitam temperature / top_p / top_k diferentes do padrão com HTTP 400 - o Foxl remove esses parâmetros automaticamente nesses modelos, para que a API use o padrão calibrado.
O seletor de modelos traz os controles: Raciocínio liga ou desliga o raciocínio (mostra Sempre ativo para um modelo que não pode desligá-lo), e Esforço lista os níveis aceitos pelo modelo selecionado (nenhum / baixo / médio / alto / xhigh / máximo, conforme o modelo oferece). Um modelo sem raciocínio ajustável não mostra níveis de esforço.
Com uma chave do Google AI, o Gemini 3.8 Flash e o Gemini 3.5 Flash-Lite aceitam os níveis de raciocínio que o Google documenta para eles: Baixo, Médio e Alto. O Gemini 3.8 Flash sempre raciocina e começa em Médio; o Gemini 3.5 Flash-Lite começa em Baixo e, com Raciocínio desligado, roda no nível mais leve do Google.
No OpenRouter, a chave e os níveis vêm do catálogo do OpenRouter para cada modelo de raciocínio, e uma configuração não alterada mantém cada modelo no padrão do próprio OpenRouter - veja Provedores de IA.
Orçamentos de Tarefa (Beta)
No Opus 5.5, Opus 5, Fable 5.1, Fable 5, Opus 4.8, Opus 4.7 e Sonnet 5, as Configurações incluem um seletor de Orçamento de Tarefa (desligado / 25K / 50K / 100K / 250K / 500K tokens). Quando definido, o modelo recebe um output_config.task_budget e o cabeçalho beta task-budgets-2026-03-13 em cada solicitação, e usa o orçamento restante para planejar e dosar seu trabalho ao longo de um turno agêntico (chamadas de ferramentas + raciocínio + resposta).
- Consultivo, não imposto. O modelo trata o valor como orientação, não como um teto rígido.
- Mínimo de 20K quando ativado. A Anthropic rejeita valores positivos abaixo disso.
- Não disponível no Opus 4.6, Sonnet 4.6 nem Haiku 4.5 - o parâmetro surgiu depois deles - e nem no Sonnet 5.5 ou Haiku 5.5, então o seletor não tem o que enviar para esses modelos.
- Aplica-se ao caminho direto da API da Anthropic (sua própria chave da Anthropic). O Bedrock Converse rejeita
output_config.task_budget("Extra inputs are not permitted"), por isso o Foxl o omite na rota do Bedrock.
Raciocínio e Custo
O raciocínio consome tokens de saída, que são os caros. Com o raciocínio ativado, um modelo pode usar de 2 a 10 vezes mais tokens de saída, dependendo da complexidade da tarefa - então um turno que custou uma fração de centavo pode custar vários centavos, para a mesma pergunta.
Como você fornece o modelo, esse custo vai para a sua fatura do provedor (ou para lugar nenhum, no caso de um modelo local), e não como uma cobrança do Foxl. Para trabalhos sensíveis a custo, desligue o raciocínio em perguntas simples e mantenha-o ligado para programação, análise e raciocínio em várias etapas, onde ele melhora de fato a resposta. Veja Custo e acesso aos modelos.
Seleção de Modelo
Aplicativo de Desktop
Clique no nome do modelo na área de entrada do chat para trocar de modelo. Sua escolha persiste entre conversas e entre reinicializações do Foxl, de modo que as execuções agendadas continuam usando-a.
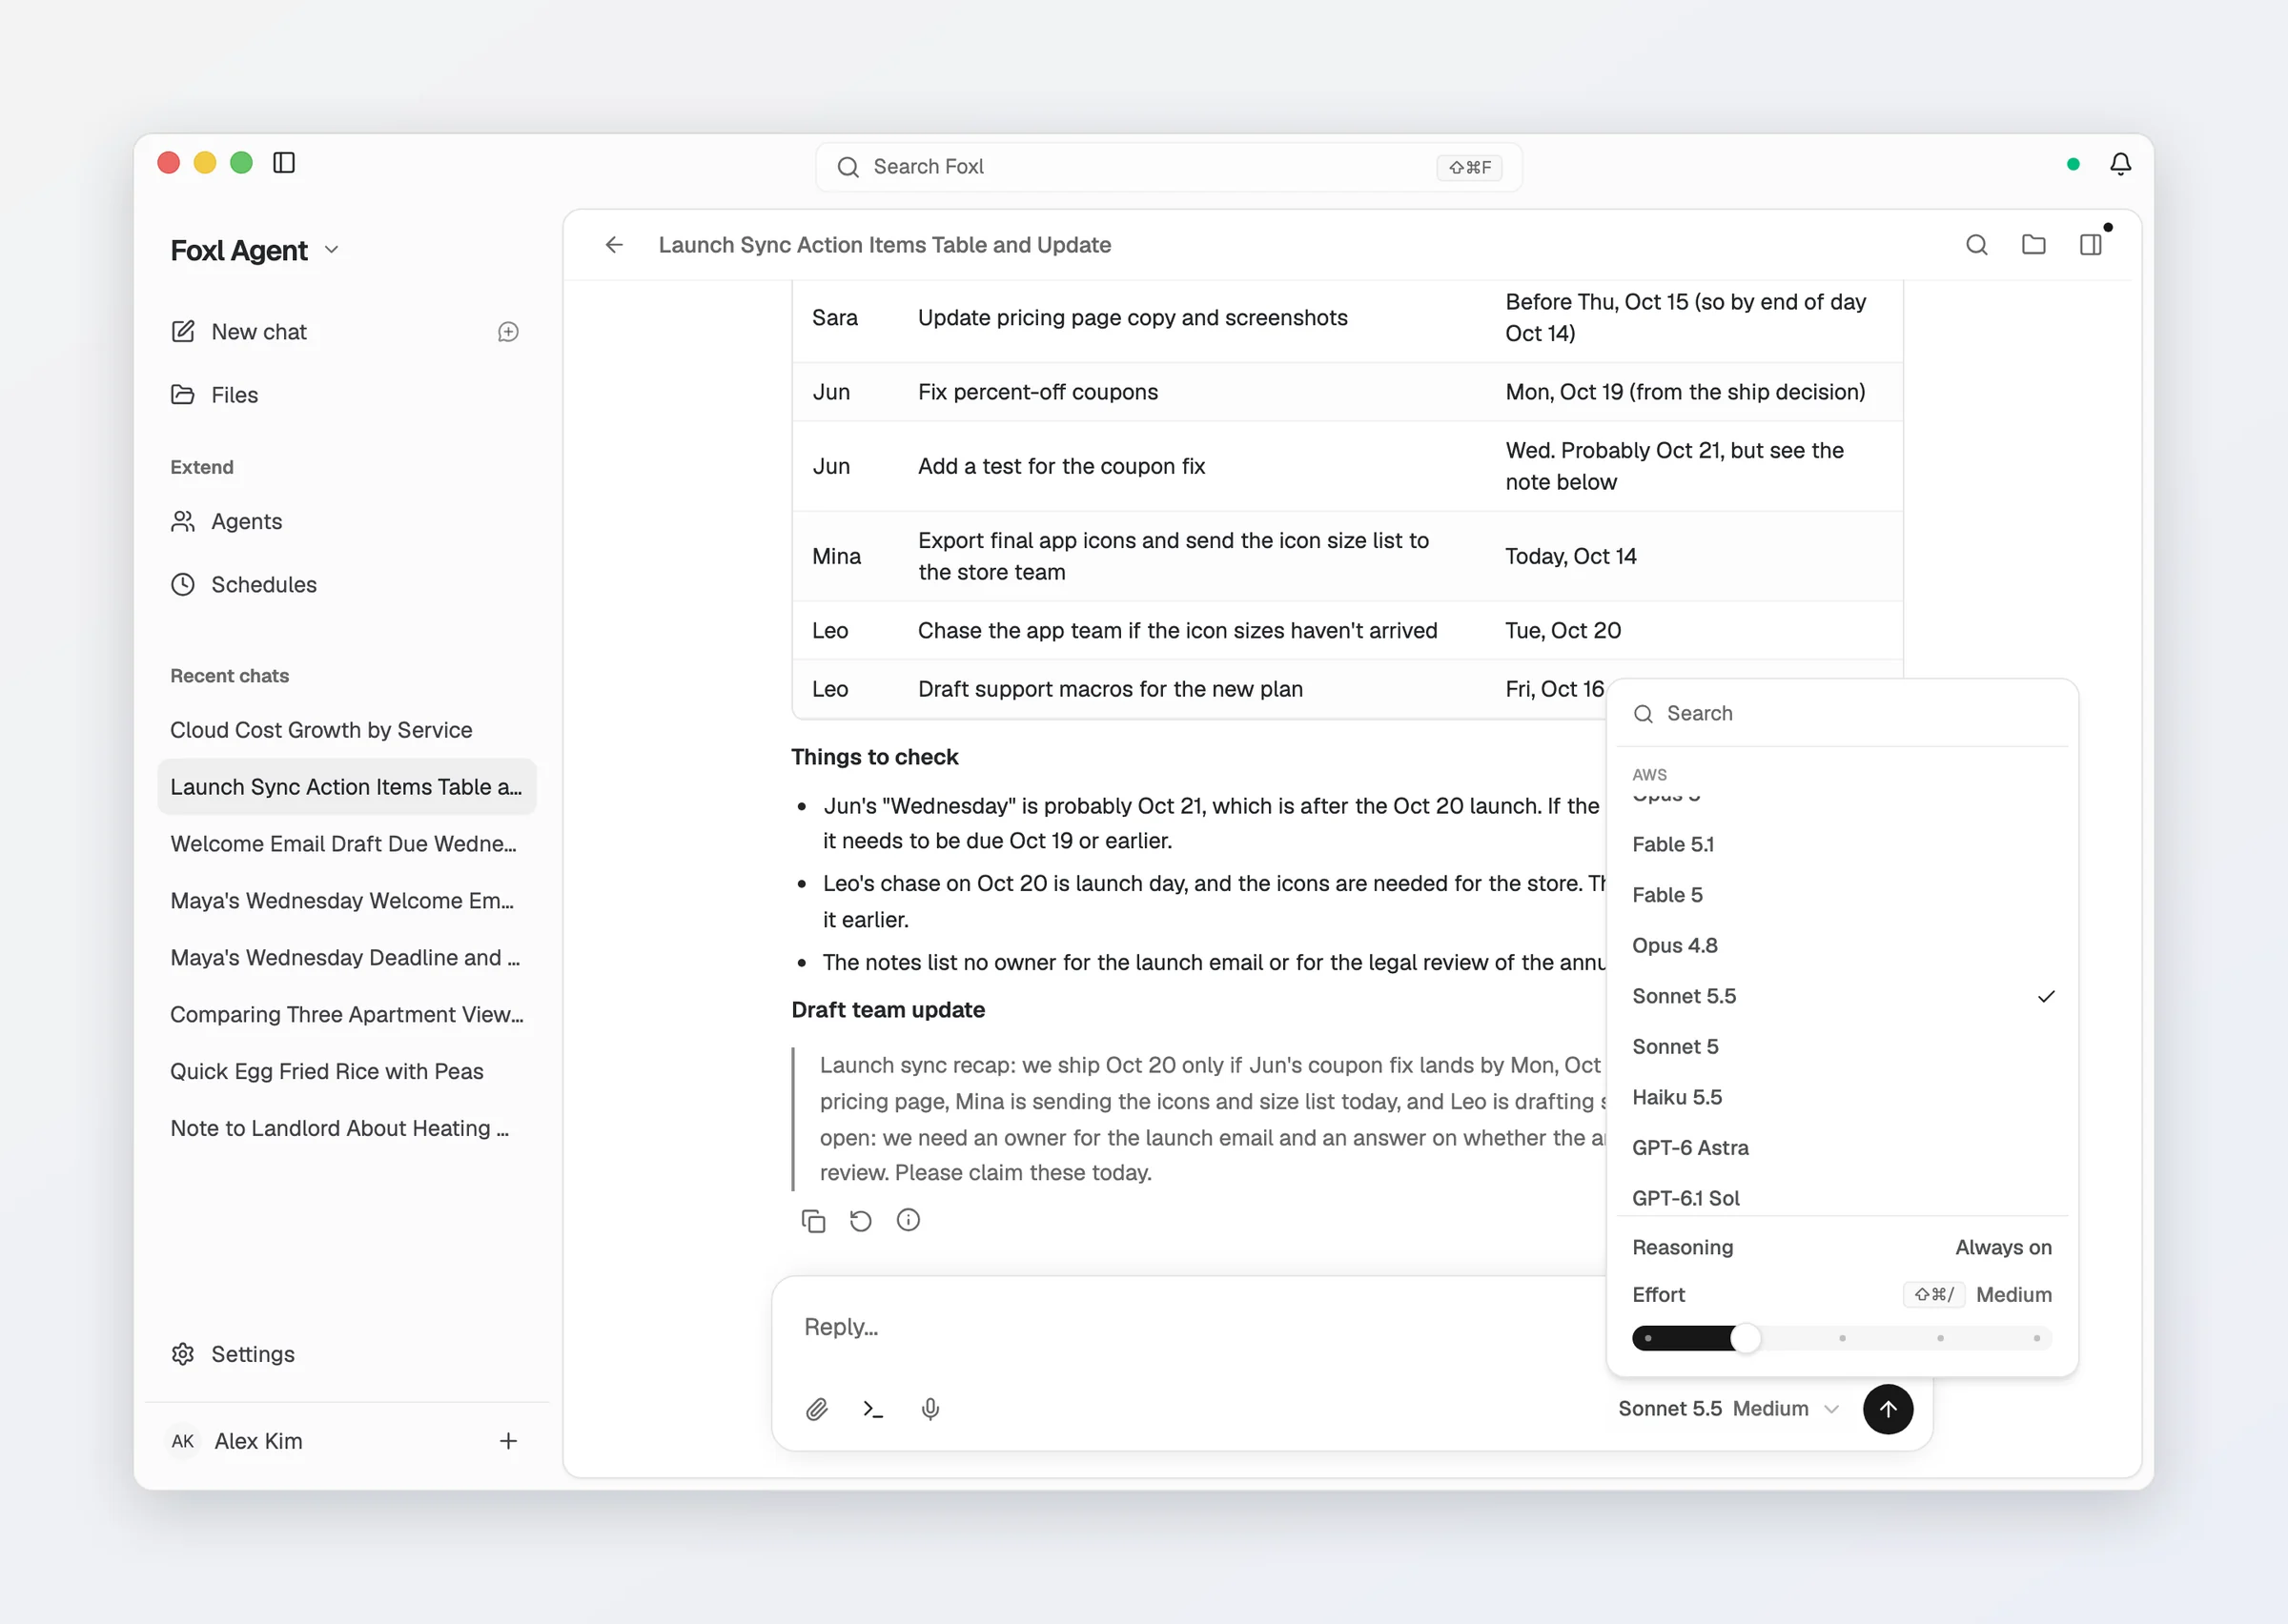
Por padrão, todo chat usa o modelo que você escolheu por último. Ative Lembrar o modelo de cada conversa em Configurações > Chat e, ao abrir um chat, o seletor muda para o modelo que você usou por último nessa conversa; assim como quando você escolhe um manualmente, esse modelo também passa a ser o usado pelos novos chats, agendamentos e canais. Essa opção vem desligada por padrão.
Aplicativo Web
No app.foxl.ai e nos aplicativos de celular, o chat roda no seu desktop Foxl, e o botão de modelo mostra o modelo que o seu desktop selecionou até que você escolha outro lá. Um modelo que você escolher no celular ou no navegador fica salvo naquele dispositivo, e uma mensagem enviada com ele também troca o modelo do seu desktop.
Nas contas em que o chat remoto está disponível, com ele ligado e o seu computador desligado, o seletor lista os modelos que uma resposta na nuvem pode usar, pelo nome, e a resposta na nuvem usa o que você escolher, com a configuração de raciocínio e a janela de contexto completa (1M tokens no Opus 5.5 e no Sonnet 5.5). A nuvem mantém a própria escolha, então o modelo que o seu computador usa não muda quando ele volta.
De qualquer forma, a lista que você vê é a que os provedores conectados oferecem. Sem nenhum provedor conectado, o seletor informa isso - Nenhum provedor conectado ainda - e oferece Abrir Modelo e provedor, e o botão do modelo mostra Conectar um modelo. Nos aplicativos web e de celular, a lista vem do seu desktop Foxl, então fica vazia enquanto o desktop estiver inacessível.
Janela de contexto e compactação
O Foxl dimensiona uma conversa pela janela de contexto do provedor pelo qual você está conectado (o mesmo modelo pode ter uma janela menor numa assinatura do que no Amazon Bedrock) e resume uma conversa longa quando a próxima requisição chegaria perto de 90% dessa janela (um pouco antes nos poucos modelos GPT cujo limite de entrada é menor que a janela, como o GPT-6 Astra). O medidor de contexto usa essa mesma janela.
Conectar um modelo
- Vá em Configurações > Modelo e provedor
- Escolha um provedor - Anthropic, OpenAI, Google AI, Amazon Bedrock, Ollama, Gemma 4 em Neste dispositivo num Mac com Apple Silicon, num PC Windows ou num computador Linux x64, um dos fornecedores compatíveis com OpenAI (OpenRouter, DeepSeek, Groq e outros, além de um servidor local vLLM ou LM Studio), ou uma assinatura OAuth. Num desktop onde nada ainda consegue responder a um chat, a configuração inicial também oferece Conectar com o OpenRouter
- Insira a sua chave de API, ou faça o login do fornecedor uma vez para o OAuth
- Selecione um modelo desse provedor
As chaves de API e os modelos locais são configurados no aplicativo de desktop. No app.foxl.ai e no celular, o chat roda no seu desktop pelo relay do desktop, então a lista de modelos ali é a que o seu desktop tem conectada - o navegador e o celular não guardam chave própria. As assinaturas OAuth funcionam da mesma forma e, além disso, leem um arquivo de credencial que a CLI do próprio fornecedor gravou no seu computador.
OAuth por assinatura
Use uma assinatura que você já paga - não é preciso chave de API.
| Assinatura | Configure uma vez com |
|---|---|
| ChatGPT Plus/Pro | Entrar com o ChatGPT em Configurações > Modelo e provedor > OpenAI (OAuth), ou npx @openai/codex login em um terminal; qualquer um grava ~/.codex/auth.json |
| Gemini CLI | gemini auth login |
Depois, escolha o provedor correspondente em Configurações > Modelo e provedor; o Foxl detecta a credencial automaticamente. Numa instalação nova cujo modelo padrão não pode rodar no computador (sem credenciais da AWS, por exemplo), o Foxl escolhe sozinho um login que encontrar, nesta ordem: Claude Code, depois ChatGPT, depois Ollama, e informa isso acima da caixa de mensagem até você escolher um modelo por conta própria; quando ele escolheu o seu login do Claude Code, esse aviso também traz o alerta sobre os termos da Anthropic. Veja Provedores de IA para detalhes de todos os provedores suportados.